[{"@type":"PropertyValue","name":"데이터 내용","value":"유럽 4개 언어의 원본 텍스트와 교정 텍스트 쌍"},{"@type":"PropertyValue","name":"데이터 규모","value":"48만 쌍"},{"@type":"PropertyValue","name":"언어","value":"프랑스어, 독일어, 스페인어, 이탈리아어"},{"@type":"PropertyValue","name":"필드","value":"입력, 출력"},{"@type":"PropertyValue","name":"데이터 형식","value":"json"}]
{"id":1515,"datatype":"1","titleimg":"https://ko.nexdata.ai/shujutang/static/image/index/datatang_tuxiang_default.webp","type1":"226","type1str":null,"type2":"228","type2str":null,"dataname":"48만 쌍 독일어·스페인어·프랑스어·이탈리아어 교정 텍스트 데이터셋|텍스트 교정 NLP 학습 데이터","datazy":[{"title":"데이터 내용","desc":"데이터 내용","content":"유럽 4개 언어의 원본 텍스트와 교정 텍스트 쌍"},{"title":"데이터 규모","desc":"데이터 양","content":"48만 쌍"},{"title":"언어","desc":"언어","content":"프랑스어, 독일어, 스페인어, 이탈리아어"},{"title":"필드","desc":"필드","content":"입력, 출력"},{"title":"데이터 형식","desc":"형식","content":"json"}],"datatag":"German, French, Spanish, Italian, proofreading","technologydoc":null,"downurl":null,"datainfo":null,"standard":null,"dataylurl":null,"flag":null,"publishtime":null,"createby":null,"createtime":null,"ext1":null,"samplestoreloc":null,"hosturl":null,"datasize":null,"industryPlan":null,"keyInformation":"","samplePresentation":[{"name":"德语样例.png","url":"https://storage-product.datatang.com/damp/product/sample_presentation/20250718142728/%E5%BE%B7%E8%AF%AD%E6%A0%B7%E4%BE%8B.png?Expires=4102415999&OSSAccessKeyId=LTAI5tEBeSWUJiqjXvBMsxEu&Signature=Mbhy3eB1XV18Pz7ETquxq%2FQXDYI%3D","intro":"","size":14337,"progress":100,"type":"jpg"},{"name":"法语样例.png","url":"https://storage-product.datatang.com/damp/product/sample_presentation/20250718142728/%E6%B3%95%E8%AF%AD%E6%A0%B7%E4%BE%8B.png?Expires=4102415999&OSSAccessKeyId=LTAI5tEBeSWUJiqjXvBMsxEu&Signature=M9EUDtOgF6kOmlk7TT21dtmjIWk%3D","intro":"","size":7576,"progress":100,"type":"jpg"},{"name":"西班牙语样例.png","url":"https://storage-product.datatang.com/damp/product/sample_presentation/20250718142728/%E8%A5%BF%E7%8F%AD%E7%89%99%E8%AF%AD%E6%A0%B7%E4%BE%8B.png?Expires=4102415999&OSSAccessKeyId=LTAI5tEBeSWUJiqjXvBMsxEu&Signature=sumS6I20jDUhBN5xTw5ESzU6aSo%3D","intro":"","size":10686,"progress":100,"type":"jpg"}],"officialSummary":"본 데이터셋은 유럽의 4대 언어인 프랑스어, 독일어, 스페인어 및 이탈리아어에 초점을 맞추고 있으며, 원문과 교정문으로 구성된 48만 쌍의 텍스트 데이터를 포함합니다. 각 데이터는 JSON 형식으로 제공되며, input(원문)과 output(교정문)의 두 가지 필드를 포함합니다. 자연어 처리, 기계 번역 및 언어 교육 연구 등에 활용할 수 있습니다.","dataexampl":null,"datakeyword":["독일어","프랑스어","스페인어","이탈리아어","텍스트 데이터"],"isDelete":null,"ids":null,"idsList":null,"datasetCode":null,"productStatus":null,"tagTypeEn":"Type","tagTypeZh":null,"website":null,"samplePresentationList":null,"datazyList":null,"keyInformationList":null,"dataexamplList":null,"bgimg":null,"datazyScriptList":null,"datakeywordListString":null,"sourceShowPage":"llm","dataShowType":"[{\"code\":\"0\",\"language\":\"ZH\"},{\"code\":\"1\",\"language\":\"ZH\"},{\"code\":\"2\",\"language\":\"EN,PT,DE,KO,FR,ES\"},{\"code\":\"3\",\"language\":\"EN\"}]","productNameEn":"480000 corrected texts in German, Spanish, French, Italian","BGimg":"","voiceBg":["/shujutang/static/image/comm/audio_bg.webp","/shujutang/static/image/comm/audio_bg2.webp","/shujutang/static/image/comm/audio_bg3.webp","/shujutang/static/image/comm/audio_bg4.webp","/shujutang/static/image/comm/audio_bg5.webp"],"firstList":[{"name":"意大利语样例.png","url":"https://storage-product.datatang.com/damp/product/sample_presentation/20250718142728/%E6%84%8F%E5%A4%A7%E5%88%A9%E8%AF%AD%E6%A0%B7%E4%BE%8B.png?Expires=4102415999&OSSAccessKeyId=LTAI5tEBeSWUJiqjXvBMsxEu&Signature=vKA%2BnWeV2e3sUC2bKtfNCE2JnQc%3D","intro":"","size":8202,"progress":100,"type":"jpg"}]}
https://ko.nexdata.ai/shujutang/static/image/index/datatang_tuxiang_default.webp
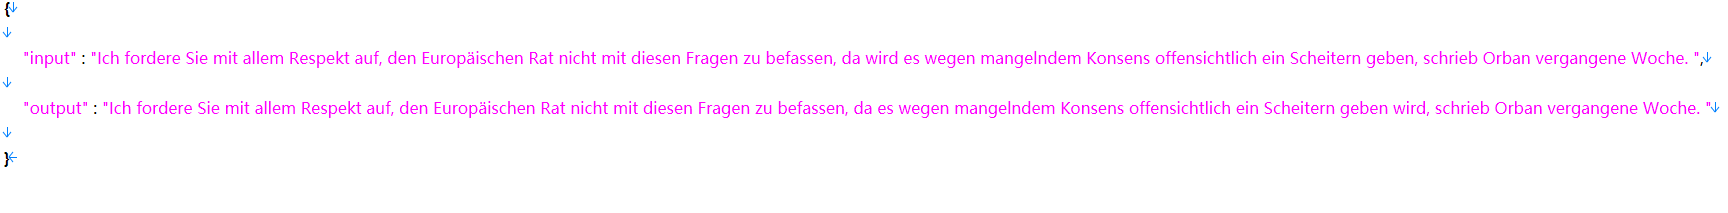
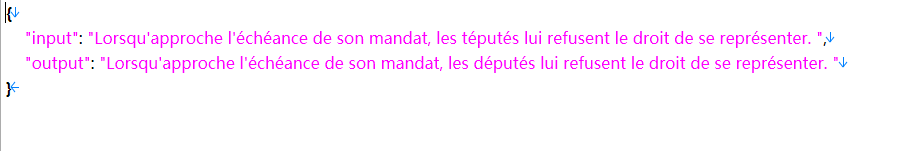
[{"@type":"ImageObject","embedUrl":"https://storage-product.datatang.com/damp/product/sample_presentation/20250718142728/%E5%BE%B7%E8%AF%AD%E6%A0%B7%E4%BE%8B.png?Expires=4102415999&OSSAccessKeyId=LTAI5tEBeSWUJiqjXvBMsxEu&Signature=Mbhy3eB1XV18Pz7ETquxq%2FQXDYI%3D"},{"@type":"ImageObject","embedUrl":"https://storage-product.datatang.com/damp/product/sample_presentation/20250718142728/%E6%B3%95%E8%AF%AD%E6%A0%B7%E4%BE%8B.png?Expires=4102415999&OSSAccessKeyId=LTAI5tEBeSWUJiqjXvBMsxEu&Signature=M9EUDtOgF6kOmlk7TT21dtmjIWk%3D"},{"@type":"ImageObject","embedUrl":"https://storage-product.datatang.com/damp/product/sample_presentation/20250718142728/%E8%A5%BF%E7%8F%AD%E7%89%99%E8%AF%AD%E6%A0%B7%E4%BE%8B.png?Expires=4102415999&OSSAccessKeyId=LTAI5tEBeSWUJiqjXvBMsxEu&Signature=sumS6I20jDUhBN5xTw5ESzU6aSo%3D"},{"@type":"ImageObject","embedUrl":"https://storage-product.datatang.com/damp/product/sample_presentation/20250718142728/%E6%84%8F%E5%A4%A7%E5%88%A9%E8%AF%AD%E6%A0%B7%E4%BE%8B.png?Expires=4102415999&OSSAccessKeyId=LTAI5tEBeSWUJiqjXvBMsxEu&Signature=vKA%2BnWeV2e3sUC2bKtfNCE2JnQc%3D"}]
48만 쌍 독일어·스페인어·프랑스어·이탈리아어 교정 텍스트 데이터셋|텍스트 교정 NLP 학습 데이터
독일어
프랑스어
스페인어
이탈리아어
텍스트 데이터
본 데이터셋은 유럽의 4대 언어인 프랑스어, 독일어, 스페인어 및 이탈리아어에 초점을 맞추고 있으며, 원문과 교정문으로 구성된 48만 쌍의 텍스트 데이터를 포함합니다. 각 데이터는 JSON 형식으로 제공되며, input(원문)과 output(교정문)의 두 가지 필드를 포함합니다. 자연어 처리, 기계 번역 및 언어 교육 연구 등에 활용할 수 있습니다.
본 데이터셋은 사업적 활용이 가능한 유료 데이터셋입니다. 즉시 활용 가능한 형태로 제공되어 AI 프로젝트에 빠르게 적용할 수 있습니다.
![사양]()
사양
데이터 내용
유럽 4개 언어의 원본 텍스트와 교정 텍스트 쌍
![샘플]()
샘플
![추천 데이터셋]()
추천 데이터셋
13524459-9b4a-4ba6-a7f2-10ce96f133a9


 사양
 샘플



 추천 데이터셋


